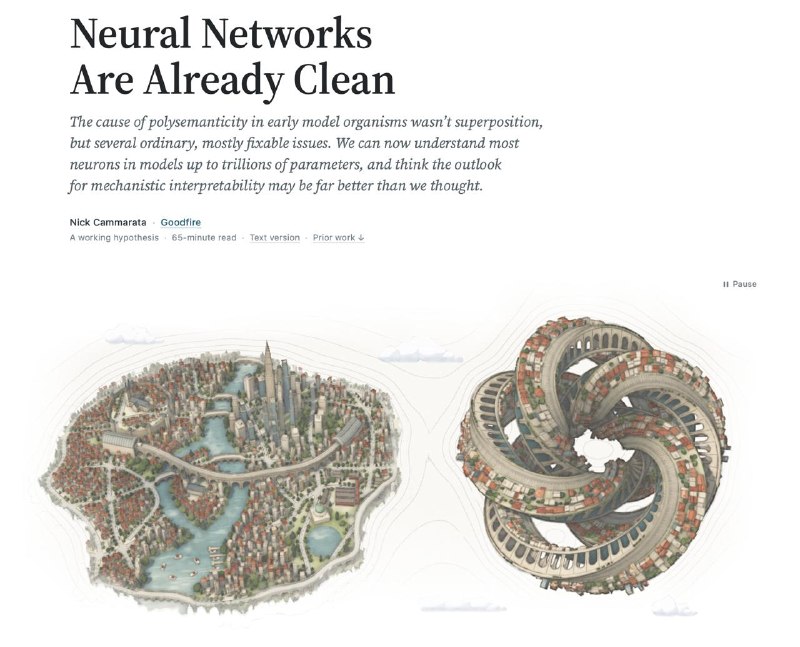
Возможно, нейросети – вовсе не черные ящики, как мы привыкли считать Ник Каммарата, известный в области интерпретируемости ученый, выпустил важнейшее огромное эссе под названием "Neural Networks Are Already Clean". Каммарата был одним из первых ученых, кто занялся интепретируемостью (он же построил команду интепретируемости в OpenAI), и выпустил несколько фундаментальных работ по этому вопросу. Сейчас он работает в Goodfire. Так вот, он выдвигает гипотезу, что нейросети на самом деле устроены проще, чем мы думаем. Все попытки интерпретировать сетки в основном строятся на предположении о суперпозиции: считается, что просто на нейроны смотреть бессмысленно, поскольку модель якобы сваливает в каждый из них массу несвязных вещей. Поэтому ученые стараются сначала распутать активации с помощью других моделей (самый известный подход – SAE), и только потом как-то работать с найденными признаками. Ник говорит, что он и сам раньше был сторонником такого подхода. Однако сейчас он утверждает, что никакая декомпозиция, возможно, не нужна, и что в нейронах на самом деле объеденены не рандомные вещи, а более глобальные концепции. Просто они не всегда очевидны для человека. Есть такая основополагающая работа для сферы интерпретируемости, как Circuits, 2020 года. Каммарата был ее соавтором, и как раз там была "доказана" суперпозиция нейросетей. Авторы разобрали GoogLeNet для распознавания изображений, и показали, что один и тот же нейрон активировался и при виде капотов машин, и при виде мордочек кошек. Этот пример до сих пор считается каноническим доказательством того, что несвязанные признаки в сетях почти беспорядочно растекаются по нейронам. Так вот в своем эссе Каммарата опроверг этот кейс. Оказалось, что две концепции смешались в этом нейроне не просто так: это был нейрон V-образной формы. Он активировался, когда нужно было отличить вытянутое от круглого, а морды кошек и капоты оказались просто наиболее частыми примерами. Каммарата показывает, что факт читаемости нейронов не зависит даже от размеров модели. Просто чем модель меньше, тем нейроны грубее в плане внутреннего признака, и тем сложнее бывает эти признаки понять. Автор называет это фрактальной природой обобщения: маленькие модели – грубое объяснение, большие – более детальное для каждого нейрона. В случае с языковыми моделями, в частости, это тоже работает. В предварительных аудитах Qwen3-32B примерно у 90% нейронов одна основная работа, у ~7% две связанные, и только 2–4% пока не поняты. Результаты похожие для моделей вплоть до триллионов параметров, включая MoE. И хотя все выводы пока крайне предположительные, автор предполагает, что тут есть параллель с «горьким уроком» Саттона, и что в интерпретируемости может сработать тот же принцип, что и в самом глубоком обучении. То есть обычное исследование нейронов в масштабе может оказаться эффективнее, чем сложные подходы.