«Анализ данных» рассказывает о Data Science, обработке данных и инструментах аналитики. В канале есть новости библиотек и технические подборки.

51 400подписчиков0переходов0просмотров страницы

Подписчики и просмотры публикации — из публичного предпросмотра Telegram; переходы и просмотры страницы — с сайта. Обновлено 16.10.2026

О канале

«Анализ данных» рассказывает о Data Science, обработке данных и инструментах аналитики. В канале есть новости библиотек и технические подборки. Среди тем — работа с большими наборами данных и изменения в аналитических инструментах, включая Polars. Лента помогает следить за экосистемой обработки и исследования данных.

Аудитория канала

Число подписчиков из публичного предпросмотра Telegram. Сохраняем реальные замеры при обновлении данных. Разрыв линии означает перерыв в замерах более трёх дней.

Первый замер: 51 400 подписчиков (16.10.26). График появится после следующего замера в другой день.

Перед подпиской

Доступ
Публичный канал
Язык публикаций
Русский
Формат
текстовые публикации, фотографии, видео, ссылки. Видны в веб-предпросмотре.
Кому подходит
Аналитикам данных и специалистам Data Science.
Последняя известная публикация
16.10.2026, 14:31:05 МСК
Проверка адреса
Адрес Telegram ответил — 16.10.2026, 16:36:37 МСК. Успешный HTTP-ответ не подтверждает действительность приглашения.
Предпросмотр Telegram
Получен 16.10.2026, 16:06:38 МСК. Это не подтверждает действительность закрытого приглашения.
Редакционная проверка сведений
16.10.2026

Принадлежность канала редакцией не подтверждена.

Как проверяются данные →

История изменений

Сохраняется с момента подключения журнала. Смена адреса сама по себе не подтверждает сохранение владельца.

  • — Доступность адреса: unknown → reachableИсточник: Фоновая HTTP-проверка адреса Telegram

Последние публикации

Обновляются раз в 2 дня
Анализ данных (Data analysis)@data_analysis_ml
Изображение публикации

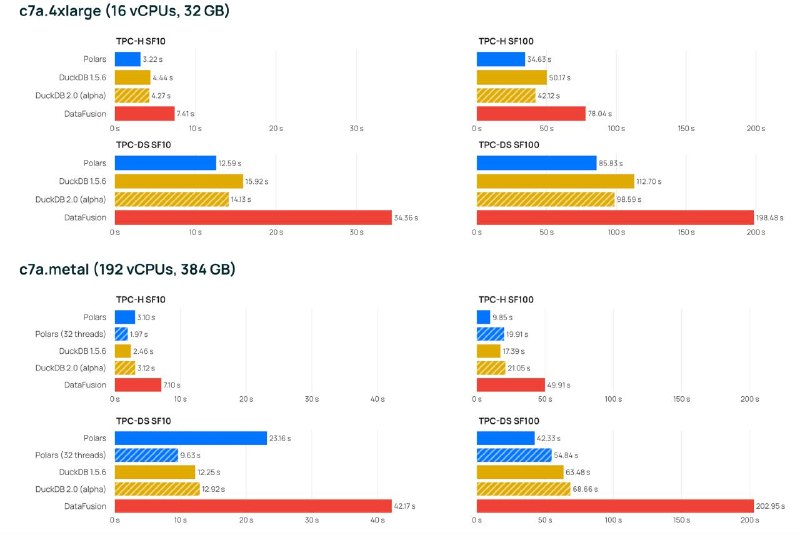
📍 Polars 2.0 вышел: стриминг по умолчанию, spill на диск и обгон DuckDB на больших данных 6 октября Ритчи Винк выпустил Polars 2.0. Главное: collect на LazyFrame теперь по умолчанию использует streaming-движок, что даёт заметный выигрыш по памяти и скорости на большинстве запросов. Вместе с ним включён out-of-core: спил на диск начинается примерно при 80% оперативной памяти, бюджет диска по умолчанию 64 ГБ. Сортировка, оконные функции и многие выражения это уже умеют, внешние join и group by в планах. SQL стал полноценным интерфейсом, а оптимизатор получил перестановку join, лучшее устранение общих подпланов и динамические предикаты с фильтрами Блума. Появился нативный dtype Map вместо List(Struct(key, value)) с выражениями map.get, map.contains_key, map.keys и map.values. Бенчмарки на основе TPC-H и TPC-DS (не сравнимы с официальными результатами) показывают, что на SF100 при росте с 16 до 192 vCPU Polars ускоряется в 3,8 раза на TPC-H и в 2,2 раза на TPC-DS, DuckDB 1.5.6 в 3,2 и 1,9 раза, DataFusion в 1,7 и 1,0. Но на SF10 картина честнее: на TPC-H Polars на уровне, а на TPC-DS медленнее в 1,8 раза. Виной постоянный оверхед на 192 потоках, при ограничении 32 ядрами Polars конкурентен везде, исправление обещают в следующем релизе. Самое важное для миграции: streaming-движок по умолчанию не гарантирует порядок строк в join, group_by и unpivot, нужен maintain_order=True. Ошибки теперь всплывают раньше, а неявная обработка несоответствий данных стала опцией. Гайд по апгрейду есть на docs.pola.rs. https://pola.rs/posts/release-polars-2/
Анализ данных (Data analysis)@data_analysis_ml
Изображение публикации

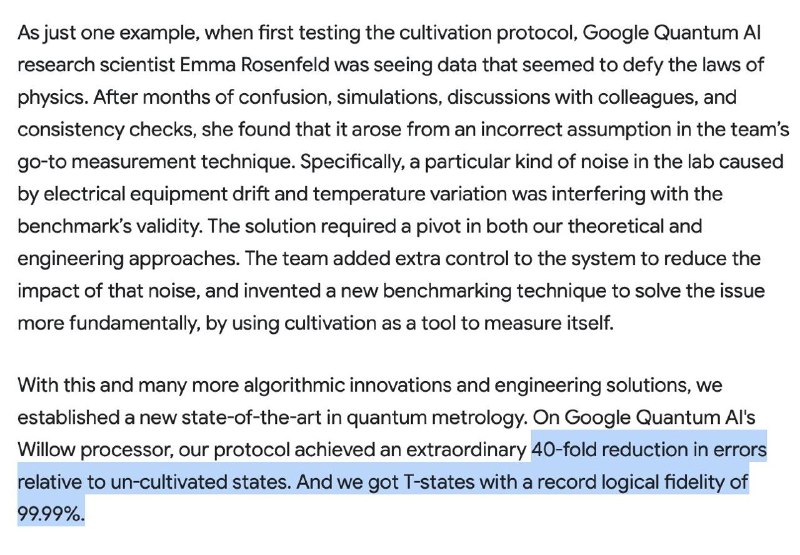
⚛️ Google показала, как снизить ошибки в одном из ключевых ресурсов квантовых вычислений в 40 раз. На процессоре Willow исследователи продемонстрировали *magic state cultivation*: подготовку специальных квантовых состояний с точностью около 99,99%. Зачем это нужно? Такие состояния позволяют выполнять операции, необходимые универсальному квантовому компьютеру. При использовании они расходуются, поэтому их приходится постоянно создавать. И это дорого: по некоторым оценкам, их производство может занимать до 95% ресурсов квантового компьютера. Метод Google работает как фильтр: последовательность измерений выявляет ошибки, а неудачные попытки отбрасываются. На реальном чипе удалось получить состояния с примерно 40-кратно меньшей ошибкой, чем без этой процедуры. Следующий этап: масштабирование. До полезных квантовых вычислений ещё остаются инженерные задачи, но один из важных методов теперь подтверждён экспериментально. Работа опубликована в Science. https://blog.google/innovation-and-ai/models-and-research/quantum-computing/magic-state-cultivation-quantum-computing/