Python/Django публикует материалы о Python, инструментах разработки и работе с данными. В ленте также есть новости ИИ и цифровых сервисов для программистов.

58 500подписчиков0переходов0просмотров страницы

Подписчики и просмотры публикации — из публичного предпросмотра Telegram; переходы и просмотры страницы — с сайта. Обновлено 16.10.2026

О канале

Python/Django публикует материалы о Python, инструментах разработки и работе с данными. В ленте также есть новости ИИ и цифровых сервисов для программистов. Канал соединяет специализированные Python-темы с более широкой технологической подборкой. Среди публикаций — проекты, библиотеки и инструменты, связанные с разработкой и ИИ-ассистентами.

Аудитория канала

Число подписчиков из публичного предпросмотра Telegram. Сохраняем реальные замеры при обновлении данных. Разрыв линии означает перерыв в замерах более трёх дней.

Первый замер: 58 500 подписчиков (16.10.26). График появится после следующего замера в другой день.

Перед подпиской

Доступ
Публичный канал
Язык публикаций
Русский
Формат
текстовые публикации, фотографии, видео, ссылки. Видны в веб-предпросмотре.
Кому подходит
Разработчикам Python и читателям новостей программных инструментов.
Последняя известная публикация
16.10.2026, 13:42:11 МСК
Проверка адреса
Адрес Telegram ответил — 16.10.2026, 15:50:27 МСК. Успешный HTTP-ответ не подтверждает действительность приглашения.
Предпросмотр Telegram
Получен 16.10.2026, 15:43:12 МСК. Это не подтверждает действительность закрытого приглашения.
Редакционная проверка сведений
16.10.2026

Принадлежность канала редакцией не подтверждена.

Как проверяются данные →

История изменений

Сохраняется с момента подключения журнала. Смена адреса сама по себе не подтверждает сохранение владельца.

  • — Доступность адреса: unknown → reachableИсточник: Фоновая HTTP-проверка адреса Telegram

Последние публикации

Обновляются раз в 2 дня
Python/ django@pythonl
Изображение публикации

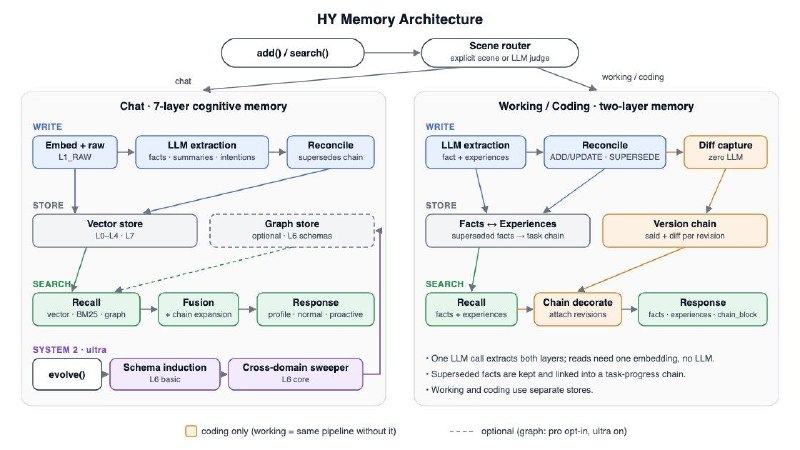
🧠 Tencent открыла Hy Memory: общую память для ИИ-ассистентов и редакторов кода Система объединяет память о переписках, работе и коде, чтобы контекст можно было использовать между Codex, Cursor, WorkBuddy и другими инструментами. Открыты модель, движок и приложение. В основе Hy-Memory-30B-A3B: 30 млрд параметров, из которых активны 3 млрд. По данным команды, система заняла первое место во всех четырёх проведённых бенчмарках, обойдя Opus 5 в тестах памяти: • +10,2 пункта на MemoryArena. • На 51,8% меньше объём памяти. • На 39,3% меньше токенов при извлечении воспоминаний. Модель работает и с чужими движками: Mem0, MemOS и EverMemOS. В одном из продуктов Tencent точность восстановления информации через несколько связанных фактов выросла с 50% до 90%. https://huggingface.co/tencent/Hy-Memory-30B-A3B

Python/ django@pythonl
Изображение публикации

🖥 Datadog научила профилировщик Python понимать asyncio: флеймграфы со «стеками из стеков» и оверхед меньше на 60% Главная боль профилирования asyncio в том, что каждая задача выглядит как независимый стек. Время в запросе к Cassandra повисает в воздухе, и непонятно, какой именно путь в приложении его породил. Инженеры Datadog решили это так: профилировщик отслеживает, какая задача кого ждёт, строит дерево зависимостей и начиная с листьев надстраивает фреймы родителей поверх фреймов потомков. Код, разбитый на отдельные задачи, и обычные корутины в одной задаче теперь дают сопоставимые флеймграфы. Если задача живёт дольше создателя, время засчитывается создателю, пока он работает, а затем тому, кто её ждёт. Цена такого подхода высокая: к стоимости на поток добавляется O(n_tasks), а серверы держат много задач, поэтому адаптивный сэмплинг местами падал до минимальной одной выборки в секунду. Резервуарное сэмплирование задач команда отвергла, потому что для дерева нужны метаданные всех задач. Оверхед срезали тремя шагами. Убрали C++ исключения из пути сэмплирования, это около 15%. Интернировали строки имён функций и файлов, ещё около 25%. Заменили process_vm_readv, по системному вызову на каждый маленький объект, на memcpy с обработчиком сигнала для восстановления после ошибок памяти, это около 50% для синхронного кода. В сумме на сервисах с выкаченными изменениями оверхед упал более чем на 60%. В проде профилировщик нашёл бесконечный цикл в библиотеке pylzstring, которую затем починили в апстриме, и внутреннюю библиотеку, строившую большие debug-строки при логгере уровня INFO. Отдельно ИИ-агент через MCP и Dynamic Instrumentation оптимизировал функ ции на NumPy и снизил CPU в них на 15-30%. Улучшения доступны в свежих версиях ddtrace. Автор отмечает, что похожий подход принят в Tachyon, профилировщике CPython 3.15, но сравнения не делает, как и абсолютных цифр оверхеда. Источник: https://www.datadoghq.com/blog/engineering/async-python-profiler/